Il SEO monitoring aiuta a riconoscere cambiamenti che richiedono attenzione. Un avviso utile porta alle pagine coinvolte e al controllo successivo; una dashboard, da sola, può mostrare un problema senza aiutare a risolverlo.
Parti dai rischi del sito. Quali template sostengono le vendite? Quale errore potrebbe estendersi a molte pagine? Quanto tempo può passare prima che qualcuno lo noti? Le risposte aiutano a scegliere frequenza e priorità dei controlli.
Monitoraggio e reporting hanno funzioni diverse
Il report riassume un periodo; il monitoraggio segnala qualcosa da verificare. “Le categorie sono cresciute nel mese” è un dato da report. “Dopo il rilascio alcune categorie restituiscono 500” richiede invece un controllo operativo.
Se ogni variazione genera una notifica, il team smette di ascoltare. Se le soglie sono troppo larghe, il sistema registra l’incidente quando il danno è già evidente.
I livelli da monitorare
Organizza i segnali in livelli collegati, perché la stessa variazione può avere cause diverse:
- disponibilità: DNS, uptime, status 5xx, timeout e latenza;
- crawlability: robots.txt, link, redirect e risorse essenziali;
- indexability: canonical, meta robots, status e sitemap;
- rendering: contenuto principale, navigazione e markup nel DOM;
- visibilità: click, impression, query e pagine;
- business: conversioni, lead, ricavi o azioni utili attribuite al traffico organico.
Questa struttura evita di saltare subito a una spiegazione algoritmica quando il server non risponde o un template ha introdotto noindex.
URL e template sentinella
Controllare soltanto la homepage lascia scoperta gran parte del sito. Seleziona URL sentinella per ogni template, mercato, lingua e stato: categoria, prodotto disponibile, prodotto esaurito, articolo, pagina locale e paginazione. Aggiungi pagine ad alto traffico e URL modificati di recente.
Le sentinelle forniscono velocità, mentre crawl e analisi più ampie misurano la copertura. Aggiorna il campione quando cambia l’architettura o nasce un nuovo template.
Status code e disponibilità
Monitora errori 5xx, picchi di 404, redirect inattesi e soft 404. Segmenta per directory e user agent: un problema può colpire soltanto Googlebot, un paese o richieste senza cookie. I log server sono spesso la prova più vicina al comportamento reale del crawler.
Per redirect e pagine rimosse, usa come riferimento la strategia di redirect 301 e la gestione degli errori 404. Non alertare su ogni 404 legittimo; cerca aumenti, pattern e URL con link o traffico.
Robots.txt, canonical e noindex
Questi segnali possono cambiare su migliaia di URL per una sola modifica di template. Controlla disponibilità e contenuto di robots.txt, canonical verso host e protocollo attesi, meta robots e header X-Robots-Tag. Confronta sia HTML iniziale sia DOM renderizzato quando il sito usa JavaScript.
Regole semplici intercettano incidenti gravi: canonical fuori dominio, percentuale di noindex sopra baseline, pagine strategiche bloccate o sitemap disabilitata. Conserva sempre l’evidenza dell’URL e del valore rilevato.
Sitemap e inventario
Monitora accessibilità, numero di URL, status delle sitemap figlie e variazioni per tipologia. Una crescita improvvisa può indicare parametri o duplicati; una riduzione può derivare da un export incompleto. Confronta gli URL dichiarati con quelli canonici e indicizzabili del sito.
La sitemap XML è un segnale di scoperta, non una garanzia di indicizzazione. Per questo il monitor deve collegarla a copertura, crawling e inventario reale.
Search Console: trend, non telemetria istantanea
Click e impression sono essenziali, ma arrivano con ritardo e possono essere influenzati da domanda, stagionalità e SERP. Usa confronti omogenei e segmenta per pagina, query, paese, dispositivo e aspetto nella ricerca. Non aprire un incidente per un singolo giorno debole senza verificare persistenza e ampiezza.
Per proprietà grandi, l’esportazione bulk consente analisi più complete e storicizzazione. Le API sono utili per report mirati, tenendo presenti limiti e aggregazioni. I KPI SEO devono collegare visibilità e risultati commerciali senza promettere causalità dove non c’è prova.
Definire alert azionabili
Ogni regola dovrebbe includere metrica, segmento, baseline, soglia, durata minima, severità e owner. “Traffico in calo” è insufficiente. “Click non-brand sulle categorie italiane inferiori del 35% rispetto alla baseline per tre giorni, senza analoga riduzione nella domanda” è molto più utile, purché dati e soglia siano adatti al sito.
Combina segnali quando possibile. Un calo di click insieme a un aumento dei 5xx e a un deploy recente ha priorità maggiore di una variazione isolata.
Due tempi di allarme diversi
Un noindex inatteso su un template commerciale richiede verifica rapida della risposta pubblica; un calo di clic richiede dati completi e un confronto adeguato. Usa quindi controlli tecnici frequenti per le URL sentinella e analisi periodiche per traffico e conversioni. La frequenza deve rispecchiare il costo del problema e la latenza della fonte.
Mostra sempre quando il dato è stato raccolto. Se la raccolta si ferma, uno schermo immobile non significa che il sito sia stabile. Distingui stato regolare e stato sconosciuto; dopo una correzione, verifica subito il difetto tecnico e osserva poi i dati di ricerca.
Raggruppa gli avvisi con causa comune e registra le manutenzioni pianificate. Puoi sospendere una notifica attesa senza cancellarne la traccia. Rivedi anche gli allarmi sempre ignorati: forse la regola non aiuta più chi deve agire.
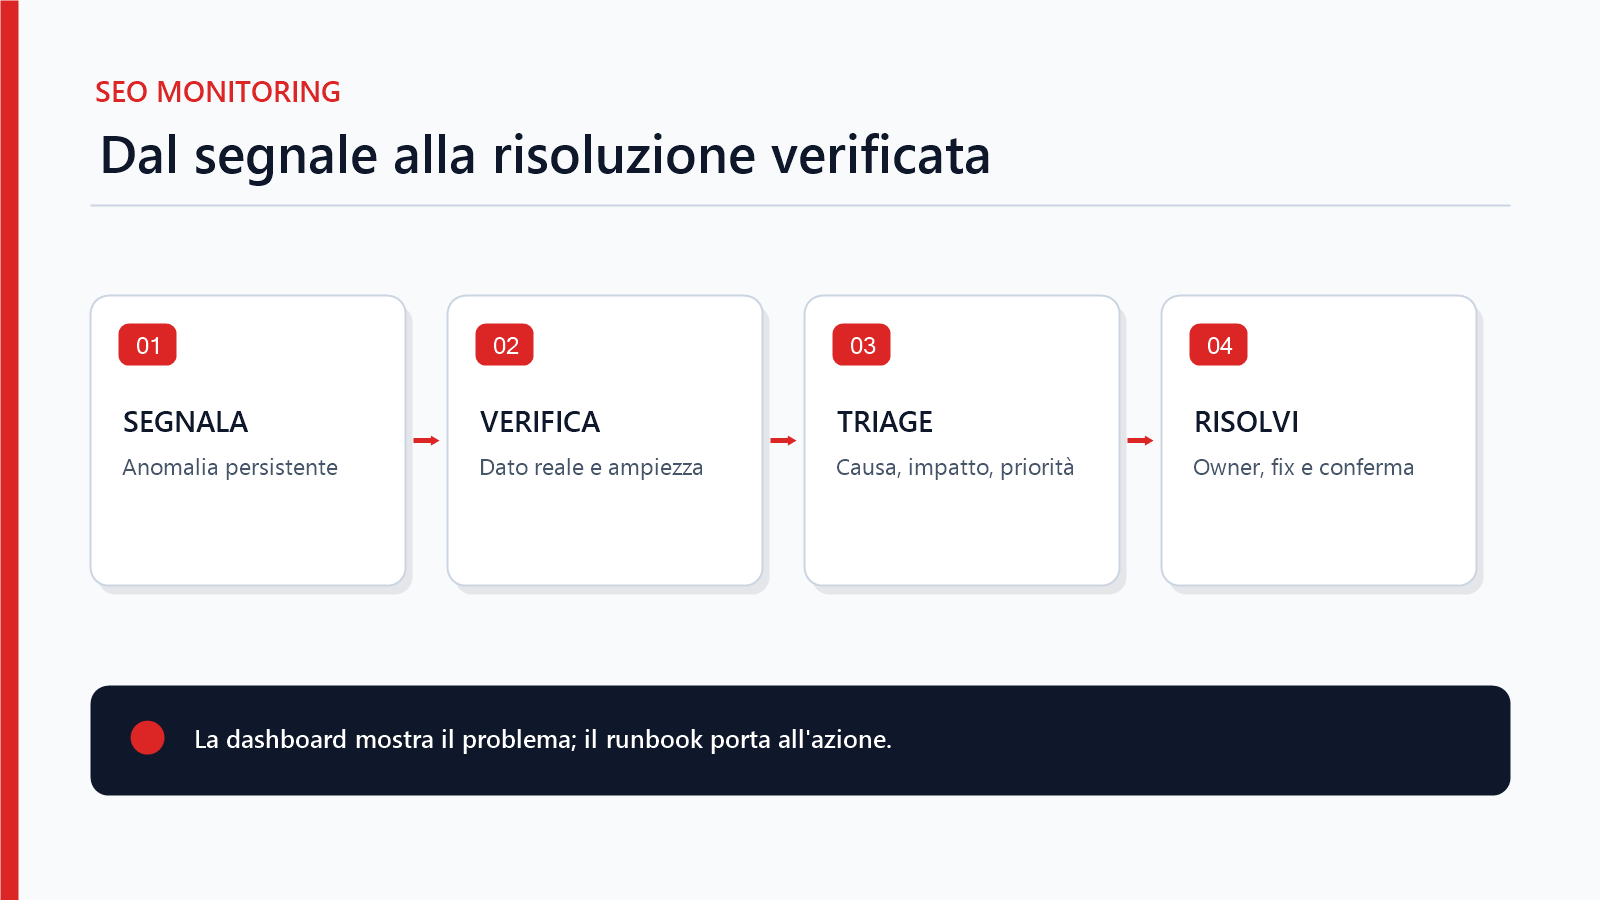
Runbook e triage
- conferma che il dato sia reale e non un errore di raccolta;
- misura ampiezza per template, mercato e periodo;
- controlla deploy, configurazioni ed eventi recenti;
- raccogli esempi riproducibili;
- assegna l’owner tecnico o editoriale;
- applica correzione o rollback;
- verifica la risposta del sito e poi i segnali ritardati.
Chiudi l’incidente con una breve causa radice e un controllo preventivo. Se lo stesso errore può tornare, trasformalo in test pre-release o in una regola automatica.
La documentazione su Search Console chiarisce che non è necessario controllare lo strumento ogni giorno e che i dati possono avere ritardo. Per incidenti tecnici usa quindi controlli sintetici e log più rapidi, poi Search Console per verificare l’effetto sulla ricerca.
Un incidente compilato, dal segnale alla chiusura
Cronologia simulata di un incidente tecnico; orari e quantità non descrivono un sito reale.
| Ora | Evidenza / decisione | Responsabile |
|---|---|---|
| 09:00 | Deploy del template categorie; versione registrata. | Sviluppo. |
| 09:05 | Due URL sentinella su cinque mostrano noindex inatteso; raccolta completa. | Monitor: allega risposte e differenza dalla baseline. |
| 09:10 | Verifica manuale su URL campione e cache pubblica; estensione al template ancora da misurare. | SEO e sviluppo: confermano priorità e perimetro. |
| 09:25 | Fix autorizzato; retest dei cinque campioni e delle varianti rilevanti. | Sviluppo esegue, SEO verifica. |
| Dopo il fix | Condizione tecnica risolta; effetto su scansione e ricerca ancora da osservare. | Owner incidente: distingue chiusura tecnica da recupero organico. |
Se una fonte non risponde, il sistema deve dire “stato sconosciuto”, non “nessun problema”. Conserva causa, evidenze, eccezioni e test preventivo. Non riaprire ogni volta lo stesso ticket per la stessa condizione già presa in carico.
Una dashboard che supporta decisioni
Mostra prima stato e anomalie, poi trend e dettagli. Separa salute tecnica, copertura organica e risultati business. Aggiungi annotazioni di deploy, migrazioni, campagne e stagionalità. Evita un unico indice di “SEO health” che nasconde segnali con impatti molto diversi.
Definire gli indicatori prima degli alert
Il monitoraggio deve partire da ciò che il sito promette: pagine importanti disponibili, contenuti scopribili, segnali coerenti e percorsi di conversione funzionanti. Per ogni promessa definisci un indicatore, una fonte, una frequenza e una soglia. Un grafico senza condizione di intervento è reporting, non monitoring.
| Area | Indicatore | Contesto necessario |
|---|---|---|
| Disponibilità | Quota di URL strategici con risposta corretta | Template, mercato e deploy |
| Scoperta | Tempo tra pubblicazione, link e primo crawl | Sitemap, profondità e log |
| Indicizzazione | URL validi presenti nell’indice | Canonical, noindex e qualità del campione |
| Visibilità | Click e impression per cluster | Domanda, device, paese e stagionalità |
| Business | Lead, ordini o margine attribuibile | Tracking, consenso e qualità della conversione |
Esempio di triage: calo delle pagine prodotto
Un alert segnala un calo di click sulle schede prodotto. Prima di attribuirlo a un aggiornamento di Google, verifica domanda e stagionalità, segmenta per mercato e dispositivo, controlla ranking e impression e cerca variazioni recenti a template, stock e dati strutturati. I log possono mostrare errori o un calo di scansione; analytics e CRM chiariscono l’impatto commerciale.
Se le impression sono stabili ma i click scendono, esamina snippet, prezzo, disponibilità e concorrenza. Se impression e pagine indicizzate calano insieme dopo un deploy, la priorità diventa tecnica. Il contesto trasforma lo stesso numero in diagnosi diverse.
Baseline dinamiche e stagionalità
Confrontare ogni giorno con quello precedente produce allarmi inutili per siti stagionali. Scegli baseline che considerino giorno della settimana, campagne, festività, migrazioni e dimensione del segmento. Per metriche sparse usa finestre più lunghe e soglie assolute; per disponibilità e status code bastano controlli più rapidi.
Annota gli eventi attesi direttamente sul monitor. Un calo durante la rimozione programmata di un mercato è informazione, non incidente; lo stesso calo senza cambi approvati richiede triage. La baseline non deve nascondere una tendenza lenta: affianca quindi confronto storico e rilevamento delle rotture improvvise.
Se scopri problemi SEO dagli utenti o settimane dopo un rilascio, contattami per costruire sentinelle, soglie e runbook adatti ai template e ai rischi del sito.