Google può eseguire JavaScript, ma questa frase non rende automaticamente indicizzabile un’applicazione. Tra richiesta, rendering e indice possono fallire routing, API, contenuti, link, status code, canonical e dati strutturati.
La JavaScript SEO verifica che utenti e crawler ricevano una pagina funzionante e che i segnali essenziali siano presenti nel momento giusto.
Risposta breve: cosa controllare su un sito JavaScript?
Confronta HTML iniziale e DOM renderizzato; verifica contenuto principale, link href, title, canonical, robots, structured data e status code. Testa route dirette, refresh, errori API e dispositivi lenti. Quando possibile usa server-side rendering, static rendering o un’architettura ibrida per fornire HTML utile senza dipendere interamente dal client.
Come Google elabora JavaScript
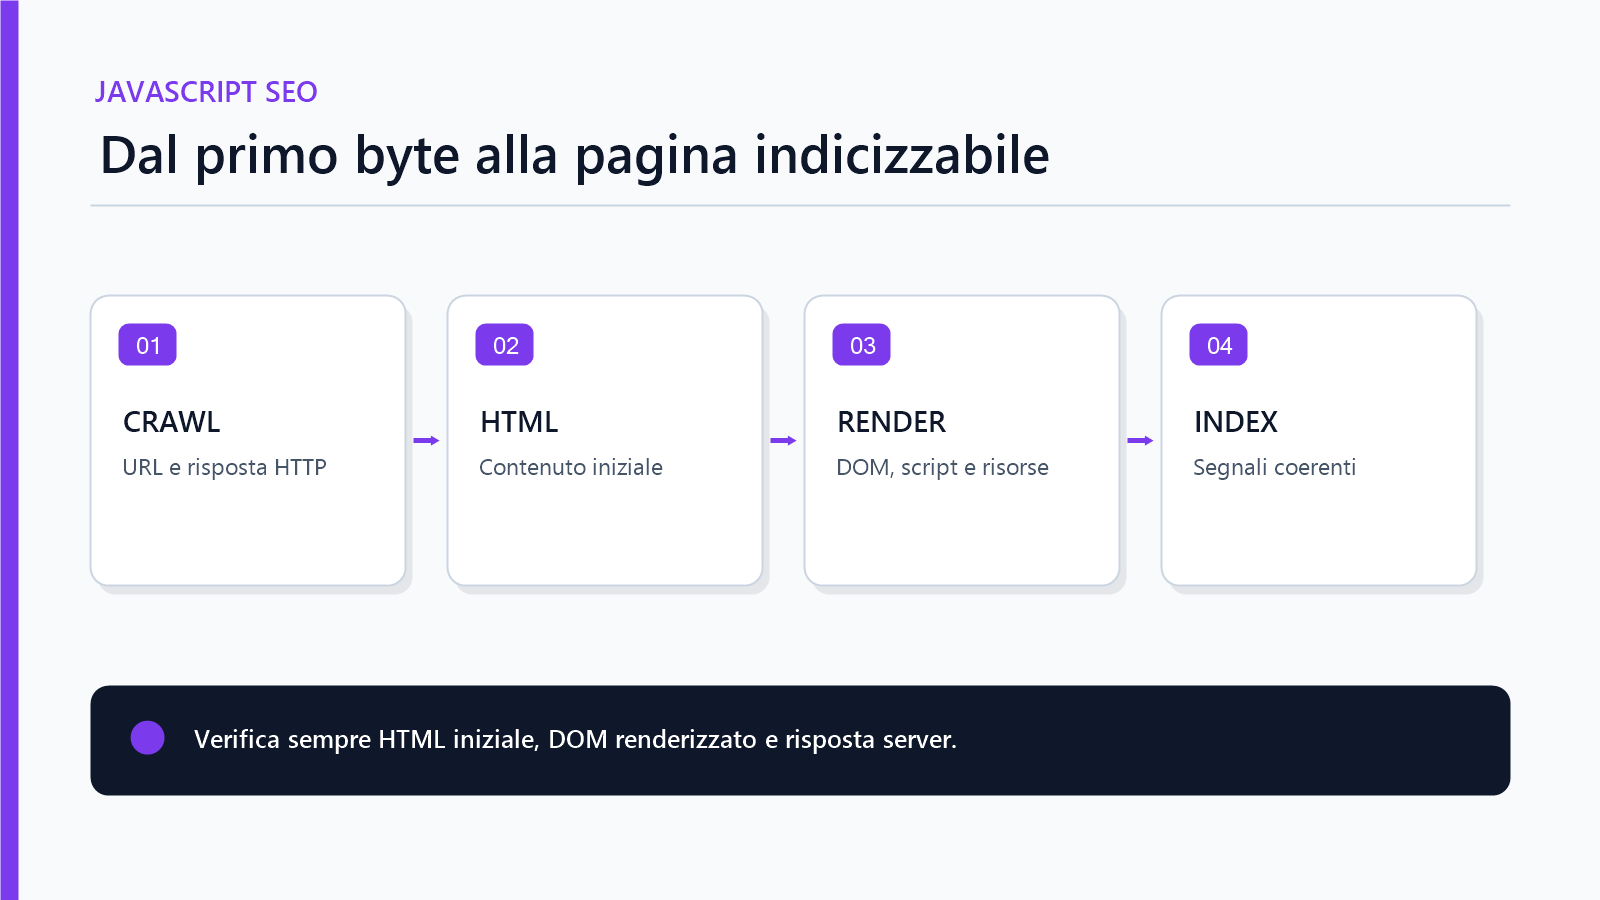
Google descrive tre fasi: crawling, rendering e indicizzazione. Il crawler scarica l’HTML, estrae i link disponibili e accoda la pagina per il rendering. Il Web Rendering Service esegue il codice e restituisce il DOM elaborato per una nuova estrazione e l’indicizzazione.
Le fasi non devono essere confuse. Una risposta 200 ricevuta non dimostra che il contenuto sia stato renderizzato né che la pagina sia stata scelta per l’indice.
HTML sorgente e DOM renderizzato
Il “Visualizza sorgente” mostra la risposta iniziale. DevTools mostra il DOM dopo l’esecuzione degli script. Confronta:
- testo e heading principali;
- link interni;
- title e meta description;
- robots e canonical;
- structured data;
- immagini e alt text;
- errori e contenuti di fallback.
Se l’HTML è un’app shell quasi vuoto, la pagina dipende dal rendering. Questo aumenta il numero di punti di guasto anche quando Google riesce normalmente a eseguire il framework.
CSR, SSR, static rendering e hydration
| Modello | Vantaggio | Rischio da verificare |
|---|---|---|
| CSR | App dinamica nel browser | HTML iniziale povero e dipendenza da API |
| SSR | Contenuto nell’HTML della richiesta | TTFB, cache e errori server |
| Static rendering | HTML pronto e distribuibile | Freschezza e tempi di build |
| Hydration | HTML iniziale con interattività | JavaScript, mismatch e INP |
Non scegliere l’architettura soltanto per Google. Considera frequenza dei dati, personalizzazione, performance, team e affidabilità. web.dev raccomanda di valutare rendering server o statico rispetto a una reidratazione completa quando il caso lo consente.
Dynamic rendering non è la soluzione di lungo periodo
Il dynamic rendering serve versioni diverse ai crawler e agli utenti tramite un renderer. Google lo considera un workaround, non una soluzione consigliata nel lungo periodo, e indica SSR, static rendering o hydration come alternative.
Se viene usato durante una transizione, assicurati che il contenuto sia equivalente. Servire informazioni sostanzialmente diverse può diventare cloaking.
Routing e URL reali
Ogni vista che deve comparire in ricerca deve avere un URL stabile e raggiungibile direttamente. Un refresh non deve restituire 404 dal server. Per le single-page application usa la History API e configura il server per le route.
Non usare frammenti # come unico modo per identificare contenuti distinti. Definisci canonical, redirect e status code a livello di route.
Status code e soft 404
Un’app può mostrare “prodotto non trovato” dentro una risposta 200. Per crawler e monitoraggio resta una pagina valida, creando soft 404. Restituisci 404 per risorse assenti, 301/308 per spostamenti permanenti e 5xx per guasti del server.
Non reindirizzare ogni errore alla home. La guida agli errori 404 spiega quando mantenere, reindirizzare o rimuovere.
Link crawlable
Google individua in modo affidabile URL negli elementi <a href="...">. Un pulsante con evento JavaScript, uno span cliccabile o un router senza href può funzionare per l’utente ma non offrire un collegamento crawlable.
Usa link reali anche quando il framework intercetta la navigazione. Verifica menu, pagination, breadcrumb, card e componenti “load more”.
Title, canonical e robots
Genera metadata univoci per route. Evita title generici durante il primo caricamento o canonical che cambiano più volte.
Google raccomanda, per siti client-rendered, di rendere il canonical il più chiaro possibile: idealmente nell’HTML iniziale e senza modifiche JavaScript. Un noindex presente inizialmente può impedire il rendering; non contare sul JavaScript per rimuoverlo.
Structured data
JSON-LD può essere iniettato con JavaScript, ma deve descrivere il contenuto visibile e restare coerente con lo stato della pagina. Evita blocchi duplicati tra server e client.
Testa il DOM renderizzato con Rich Results Test e controlla le pagine in Search Console. Un markup valido sintatticamente può essere ancora sbagliato dal punto di vista dei dati.
Risorse bloccate e chiamate API
Se robots.txt blocca JavaScript o CSS necessari, Google può non comprendere la pagina. Anche API protette, lente o dipendenti da cookie possono restituire contenuto incompleto al renderer.
Googlebot esegue il rendering in un ambiente stateless: non fare affidamento su session storage, azioni precedenti o login per mostrare contenuto pubblico.
Pagination, infinite scroll e filtri
I crawler non fanno clic su pulsanti per scoprire tutto il catalogo. Fornisci URL paginati e link sequenziali. Per filtri e sort decidi quali combinazioni devono essere crawlable e indicizzabili.
La guida alla faceted navigation SEO aiuta a controllare spazi di URL generati dal client.
Debugging: un protocollo ripetibile
- Richiedi la route senza JavaScript e salva l’HTML.
- Renderizza con browser e registra console e rete.
- Confronta contenuto, link e metadata.
- Usa URL Inspection e Rich Results Test.
- Simula API lente, errori e cache vuota.
- Controlla status code dal server.
- Verifica mobile, routing diretto e refresh.
- Monitora log e Search Console dopo il rilascio.
Provare una route con caricamento diretto
Apri una pagina prodotto incollando la sua URL in una nuova sessione, poi raggiungi la stessa pagina dalla navigazione interna. Se funziona soltanto il secondo percorso, il router client può nascondere un errore della risposta server. Verifica status Document, contenuto iniziale e destinazione canonical in entrambi i casi.
Ripeti il test con una URL inesistente e con una richiesta API fallita. Un catalogo che risponde sempre 200 e mostra soltanto uno stato di caricamento richiede una gestione degli errori più chiara. Confronta inoltre title, canonical e contenuto prima e dopo hydration: la versione iniziale corretta non basta se il client la sostituisce. Google descrive elaborazione e vincoli nella guida JavaScript SEO.
Performance e Core Web Vitals
SSR può migliorare il primo contenuto ma una hydration pesante può bloccare l’interazione. CSR può ritardare la scoperta delle risorse. Misura LCP, INP e CLS su utenti reali e template.
La guida ai Core Web Vitals è specifica per WordPress, ma il metodo field–lab–fix resta utile per qualsiasi stack.
Migrazione a un nuovo framework
Conserva il contratto degli URL, prepara redirect, confronta metadata e contenuti tra vecchio e nuovo rendering e testa sitemap, hreflang e structured data. Esegui crawl pre e post rilascio.
Segui una checklist di migrazione SEO con rollback e monitoraggio. Una migrazione frontend è comunque una migrazione SEO.
Checklist JavaScript SEO
- Contenuto principale presente dopo il rendering.
- Route accessibili direttamente.
- Status code reali.
- Link HTML con href.
- Title, robots e canonical coerenti.
- Structured data unico e visibile.
- Risorse e API accessibili.
- Pagination crawlable.
- Rendering testato su errori e lentezza.
- Core Web Vitals e log monitorati.
JavaScript non deve nascondere il contenuto
Il framework è un mezzo. Una buona implementazione rende contenuti, link e segnali robusti anche quando rete, API o rendering non sono perfetti.
Diagnosi a quattro viste: server, browser, Google e utente
Un audit JavaScript SEO diventa più affidabile quando la stessa route viene osservata da quattro prospettive. La risposta HTTP mostra status code, header e HTML iniziale; il browser mostra DOM renderizzato, rete e console; URL Inspection indica ciò che Google ha recuperato e renderizzato; il test utente rivela se la pagina resta utilizzabile con rete lenta, API in errore o hydration incompleta. Nessuna singola vista sostituisce le altre.
| Vista | Domanda | Errore tipico |
|---|---|---|
| Server | Quale contenuto e quale status arrivano subito? | Pagina assente restituita con 200 |
| Browser | Che cosa aggiungono framework e API? | Errore JavaScript che lascia un contenitore vuoto |
| Quale versione è stata recuperata e renderizzata? | Risorsa essenziale bloccata o timeout | |
| Utente | La route risponde e permette di agire? | Contenuto visibile ma interazione bloccata |
Esempio: una scheda prodotto dopo la hydration
Consideriamo una scheda il cui server invia nome e descrizione, mentre prezzo, disponibilità e variante vengono caricati da un’API. Nel DOM finale tutto sembra corretto, ma l’API risponde soltanto dopo un cookie geografico. Per un renderer stateless l’offerta può restare vuota; il markup Product può mostrare un prezzo diverso e il canonical può essere riscritto quando l’utente cambia colore.
La correzione non è “passare a SSR” in astratto. Occorre decidere quali informazioni sono essenziali per comprendere la pagina e renderle disponibili in modo stabile: identità del prodotto, offerta principale, canonical, robots, link alle varianti e dati strutturati coerenti. CSR, SSR, SSG e rendering ibrido sono modelli di consegna; la qualità dipende dal contratto tra route, dati e stato HTTP.
Una matrice di accettazione per ogni template
Per evitare controlli sporadici, crea casi di test per categoria, prodotto, ricerca interna, pagina vuota, redirect e errore server. Ogni caso deve specificare HTML atteso, contenuto dopo il rendering, status, title, canonical, robots, structured data e link principali. Esegui la matrice in anteprima e dopo il deploy, includendo accesso diretto, refresh e navigazione client-side.
La documentazione ufficiale sulla JavaScript SEO descrive le fasi di crawling, rendering e indicizzazione. Collegare la fonte alla specifica decisione tecnica è più utile di una bibliografia isolata: qui il punto operativo è che il rendering non corregge status code, route o collegamenti progettati male.
- Confronta automaticamente HTML e DOM sugli elementi SEO essenziali.
- Registra errori di rete, dipendenze da cookie e tempi delle API.
- Blocca il rilascio se canonical, robots o structured data cambiano in modo inatteso.
- Ripeti il controllo su una selezione di URL reali, non soltanto sulla homepage.
Richiedi un audit JavaScript SEO del rendering e dell’indicizzazione