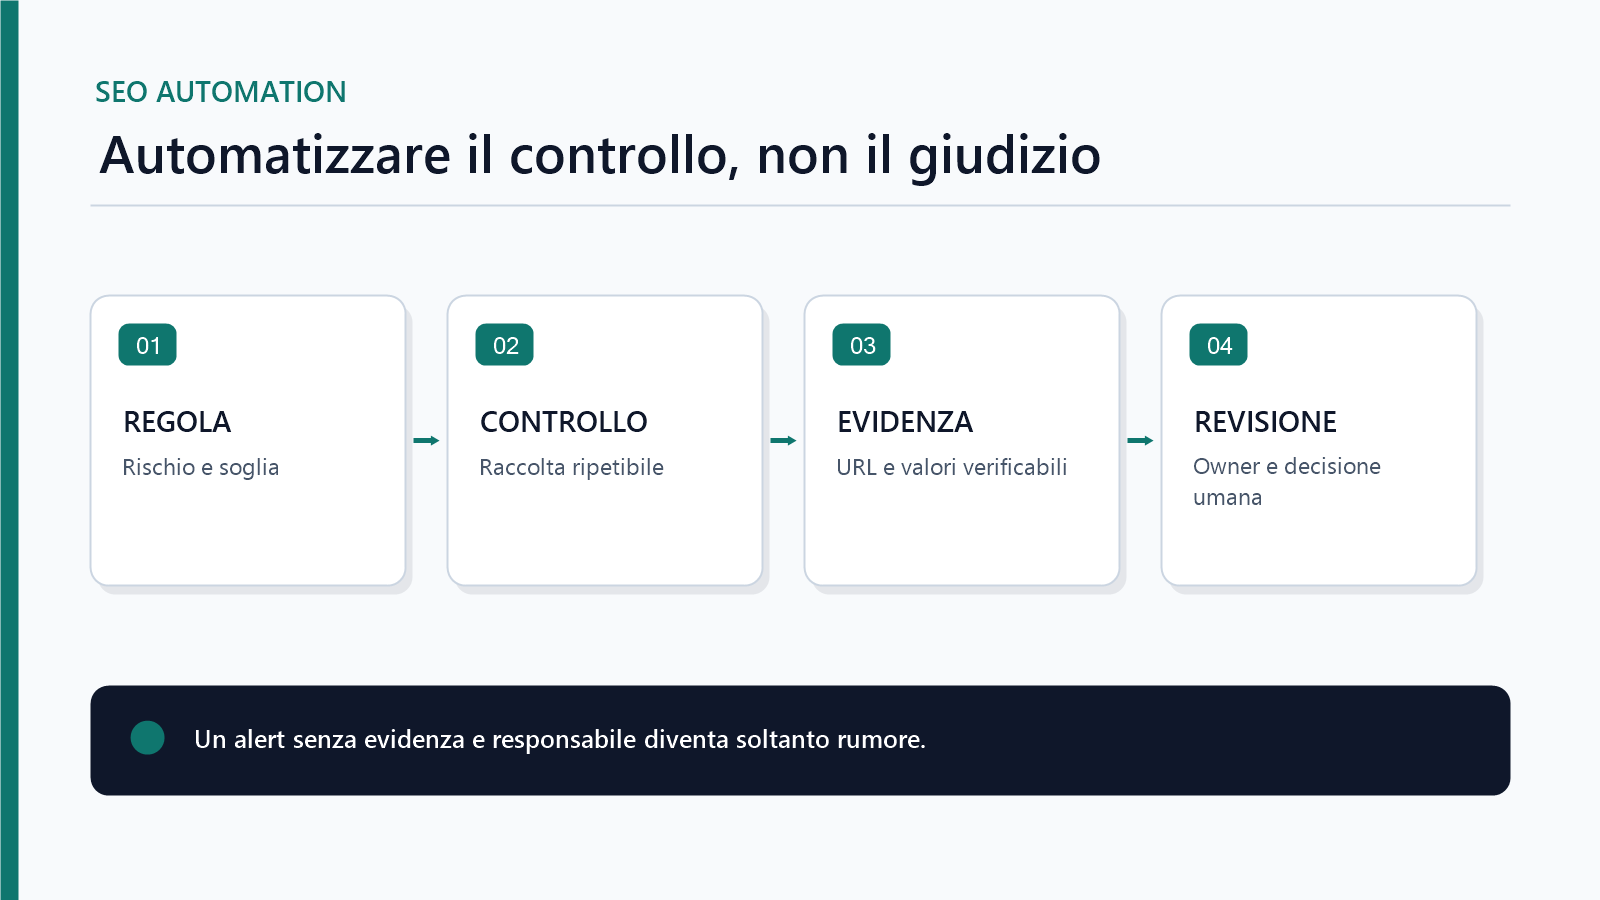
La SEO automation rende ripetibili controlli come status, canonical e sitemap. È utile soprattutto quando il sito cambia spesso. Per ogni avviso devono però esserci una prova leggibile e una persona che sappia che cosa controllare.
Automatizza la raccolta e il confronto dei dati, lasciando esplicite le decisioni che richiedono contesto. Lo script può segnalare una differenza; non sempre può stabilire se sia un errore.
Che cosa automatizzare per primo
Inizia da anomalie con conseguenze chiare: un noindex esteso, una sitemap vuota o canonical verso lo staging. Per tono dei contenuti e intento di ricerca servono invece valutazioni che una soglia numerica non riassume bene.
Una matrice iniziale può valutare ogni controllo per impatto, frequenza, rilevabilità e costo del falso positivo. Automatizza prima gli elementi con alto rischio e segnale netto.
Controlli tecnici adatti all’automazione
- status code e catene di redirect su URL strategici;
- presenza e coerenza di title, canonical, robots e hreflang;
- variazioni nel numero di URL delle sitemap;
- pagine indicizzabili escluse dalla navigazione;
- errori JSON-LD e proprietà essenziali mancanti;
- regressioni di performance per template;
- link interni verso 404 o ambienti non produttivi;
- contenuti o componenti critici assenti nel DOM renderizzato.
Questi controlli diventano più efficaci se derivano dalla checklist SEO tecnica già usata nei rilasci, così manuale e automazione condividono le stesse aspettative.
Dati, regole ed evidenze
Ogni automazione dovrebbe dichiarare quale fonte usa, con quale frequenza, quale condizione segnala e quali esempi conserva. “Canonical errato” è troppo vago; “più del 5% delle schede campionate punta a un host diverso da quello atteso” è verificabile e indirizza il triage.
Conserva URL, valore precedente, valore nuovo, timestamp e release associata. Un grafico aggregato può mostrare l’anomalia, ma per correggerla servono esempi riproducibili.
Una regola senza modifiche automatiche al sito
Questa funzione JavaScript lavora soltanto su un campione già raccolto. Non effettua richieste e non modifica URL, canonical o WordPress. L’atteso viene deciso prima del test: non è sempre uguale all’URL richiesto, perché possono esistere duplicati legittimi.
function classify(sample) {
  if (!sample || sample.complete !== true || !Array.isArray(sample.canonicals) || typeof sample.expectedCanonical !== 'string' || !Number.isInteger(sample.status)) return {state: 'unknown', reason: 'Raccolta incompleta o non valida'};
  if (sample.status !== 200) return {state: 'alert', reason: 'HTTP inatteso'};
  if (sample.canonicals.length !== 1) return {state: 'alert', reason: 'Canonical assente o multiplo'};
  if (sample.canonicals[0] !== sample.expectedCanonical) return {state: 'alert', reason: 'Destinazione diversa da quella approvata'};
  return {state: 'ok', reason: 'Controllo canonical superato'};
}
const sample = {
"complete": true,
"status": 200,
"canonicals": [
"https://example.com/"
],
"expectedCanonical": "https://example.com/categoria/"
};
console.log(classify(sample));
// { state: "alert", reason: "Destinazione diversa da quella approvata" }Tre campioni di prova (fixture) devono produrre esiti distinti: campione completo e coerente → ok; destinazione inattesa → alert; raccolta incompleta → unknown. Aggiungi casi per nessun canonical, due canonical ed errore HTTP. Il test controlla una regola limitata, non “la SEO”: direttive robots, contenuto e scelta di Google richiedono verifiche separate. La gestione dell’incidente appartiene al SEO monitoring.
Soglie e baseline
Una soglia fissa funziona per alcune condizioni binarie, come un robots.txt non raggiungibile. Per metriche variabili è spesso migliore una baseline per giorno della settimana, mercato o template. Il traffico di domenica non va confrontato senza contesto con quello di lunedì; il crawl di un catalogo stagionale non è stabile tutto l’anno.
Evita modelli sofisticati prima di avere dati puliti. Una media mobile, una banda percentuale e una regola di persistenza possono ridurre molti falsi allarmi. L’alert dovrebbe attivarsi quando la variazione è abbastanza grande e abbastanza duratura da richiedere attenzione.
Nell’avviso includi dato precedente, cambiamento, pagine coinvolte e primo controllo. Raggruppa gli eventi con la stessa causa: cento notifiche per un unico errore rendono più difficile intervenire.
- Versiona regole e soglie insieme al codice.
- Testa falsi positivi e falsi negativi su dati storici.
- Conserva un audit trail di input, decisione e risultato.
- Limita permessi e raggio d’azione delle correzioni automatiche.
- Prepara kill switch e rollback prima dell’esecuzione.
Automazione pre-release e post-release
Nel CI o nel processo di deploy, controlla una selezione rappresentativa di route e template. Verifica metadati, status, canonical, link e markup prima che la modifica raggiunga tutti gli utenti. Per i siti con generazione statica, controlla anche che la build produca l’inventario previsto.
Dopo il rilascio esegui smoke test sull’ambiente reale. CDN, regole edge, variabili e integrazioni esterne possono comportarsi diversamente dallo staging. Collega l’esito al deploy e prevedi una decisione di rollback per gli errori critici.
API di Search Console e limiti del dato
Le API possono automatizzare estrazioni di performance, sitemap e ispezioni selettive, ma non rappresentano un database completo di tutte le query o tutti gli URL. Campionamento, aggregazione, privacy e latenze richiedono interpretazione. L’assenza di un URL in un’estrazione non dimostra da sola che non abbia visibilità.
Per analisi più estese, l’esportazione bulk può alimentare un warehouse. Mantieni dimensioni, filtri e fuso orario coerenti; documenta ogni trasformazione. Confronta i dati con analytics e KPI SEO orientati al business.
Crawling automatico senza creare carico inutile
Un crawler interno può trovare regressioni, ma deve rispettare capacità e finestre operative. Non scansionare milioni di URL a ogni commit. Usa campioni per template, URL ad alto valore e pagine modificate; riserva crawl completi a frequenze appropriate.
Evita inoltre di generare involontariamente nuovi URL tramite filtri, calendario o ricerca. Il controllo stesso non deve diventare una fonte di carico o di dati inquinati nei log.
Falsi positivi, deduplicazione e priorità
Diecimila URL con lo stesso difetto di template rappresentano un incidente, non diecimila ticket. Raggruppa per causa probabile, componente, release e owner. Assegna severità in base a indicizzabilità, quota di traffico, conversioni e ampiezza.
Prevedi una finestra di soppressione per manutenzioni note e una scadenza per ogni eccezione. Un alert ignorato per settimane non è monitoraggio: è rumore.
Gestire dati mancanti e tentativi ripetuti
Un job che non riceve dati non deve registrare automaticamente “zero errori”. Prevedi stati distinti: eseguito senza anomalie, eseguito con anomalie e controllo non completato. Per timeout o limiti API applica tentativi limitati e conserva data dell’ultima esecuzione valida, motivo del fallimento e copertura effettiva.
Se l’automazione propone o applica una modifica, assegna un identificatore stabile all’operazione e rileggi la versione corrente prima di agire. Ripetere lo stesso job non deve creare duplicati o sovrascrivere una correzione manuale più recente. Prova il flusso su un campione e simula fonte indisponibile, risposta parziale e dato inatteso. Il risparmio di tempo va confrontato con manutenzione, revisione e costo degli errori.
Il controllo umano resta necessario
L’automazione può rilevare che un title è duplicato; non può decidere sempre se le pagine dovrebbero essere consolidate. Può segnalare un calo di impression; non dimostra che la causa sia tecnica. Il sistema deve consegnare evidenze a chi conosce prodotto, mercato e release.
Definisci per ogni alert owner, tempo atteso di presa in carico, runbook e criterio di chiusura. Una correzione è conclusa soltanto dopo la verifica sul sito e, quando necessario, nei dati successivi.
Roadmap pratica di SEO automation
- inventaria rischi ricorrenti e incidenti passati;
- scegli pochi controlli ad alto segnale;
- definisci baseline, soglie ed esempi;
- assegna owner e runbook;
- testa su dati storici e in shadow mode;
- attiva notifiche gradualmente;
- misura falsi positivi e tempo di risoluzione.
Automazione SEO come sistema di controllo
Una buona automazione non si limita a eseguire uno script: osserva uno stato, applica una regola, conserva l’evidenza e indirizza l’eccezione alla persona giusta. La decisione di correggere automaticamente dipende da reversibilità, impatto e certezza. Segnalare un canonical cambiato è diverso dal riscriverlo su migliaia di URL.
| Tipo di attività | Automazione adatta | Controllo umano |
|---|---|---|
| Raccolta | Crawl, API, sitemap, log e metriche | Definizione delle fonti affidabili |
| Validazione | Regole su status, canonical e markup | Gestione delle eccezioni |
| Priorità | Impatto, scala e template coinvolto | Valore commerciale e rischio |
| Correzione | Solo azioni reversibili e deterministiche | Approvazione per modifiche editoriali o ampie |
| Verifica | Retest e confronto con baseline | Chiusura dell’incidente |
Esempio: canonical cambiati dopo un deploy
Il monitor rileva che il 20% del campione di categorie punta improvvisamente alla homepage. L’automazione deve allegare URL, HTML, template, versione del deploy e differenza rispetto alla baseline. Può aprire un ticket e fermare una pipeline se la soglia è stata concordata; non dovrebbe scegliere da sola il canonical corretto quando esistono eccezioni di mercato o filtri strategici.
Dopo la correzione, lo stesso controllo verifica risposta HTTP, canonical renderizzato e assenza della regressione su altri template. Una chiusura senza retest produce soltanto un falso senso di sicurezza.
Fonti e API non sono intercambiabili
Search Console, analytics, crawler e log misurano aspetti diversi e hanno latenze differenti. Un sistema affidabile esplicita timestamp, finestra, dimensione e limiti della fonte. La guida ufficiale su come usare Search Console aiuta a interpretarne il ruolo: è una fonte importante per performance e indicizzazione, non un monitor in tempo reale di ogni evento del sito.
Testare l’automazione come un prodotto
Costruisci fixture per pagine valide, errori noti ed eccezioni legittime; poi esegui la regola in modalità osservazione prima di abilitarne gli effetti. Confronta il risultato automatico con decisioni umane campionate e registra dove divergono. Una precisione media non basta se gli errori colpiscono pagine ad alto valore.
Quando cambiano template o fonti, ricontrolla anche lo script che li osserva. Conserva le versioni del controllo e del sito, così puoi capire se l’allarme descrive un difetto reale o una regola rimasta indietro.
Se i controlli SEO dipendono da fogli manuali o gli alert non portano a un’azione chiara, contattami per progettare un sistema proporzionato ai rischi e al ritmo di rilascio del sito.