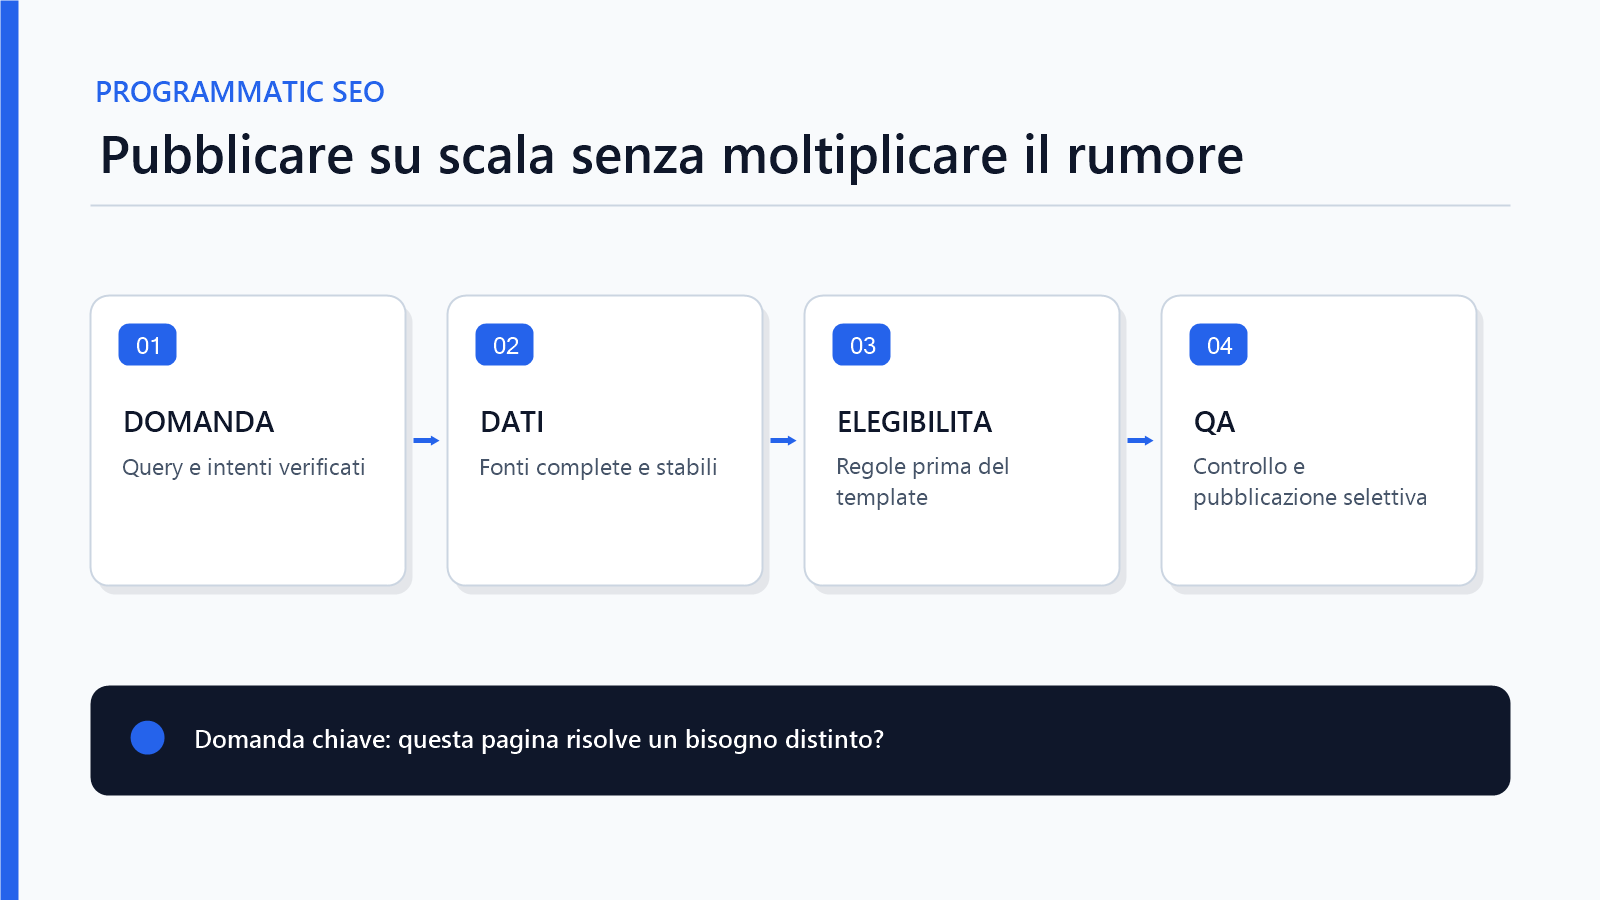
La programmatic SEO non consiste nel generare migliaia di pagine e aspettare che Google scelga quelle buone. È un sistema editoriale e tecnico che trasforma dati affidabili in pagine utili, pubblicandole soltanto quando esistono domanda, contenuto sufficiente e una destinazione realmente distinta.
La scala amplifica tutto: un template valido può coprire un catalogo enorme, ma una regola sbagliata può creare duplicati, index bloat e contenuti senza valore in poche ore.
Risposta breve: quando funziona la programmatic SEO?
Funziona quando un insieme ampio di bisogni può essere soddisfatto con dati strutturati, logica editoriale e template che producono una risposta autonoma. Prima della pubblicazione servono criteri di eleggibilità, controllo qualità, architettura di link, canonical, sitemap e monitoraggio. Se la pagina esiste soltanto per intercettare una variante di keyword, il progetto parte dalla direzione sbagliata.
Programmatic SEO e scaled content abuse
Google definisce scaled content abuse la produzione di molte pagine create principalmente per manipolare i risultati e non per aiutare le persone, indipendentemente dal fatto che siano generate da AI, scraping, template o lavoro manuale.
Il punto non è l’automazione. È il valore. Un database di specifiche verificabili, disponibilità, confronti o informazioni locali può alimentare pagine utili. Combinare testi generici e keyword senza una risposta distinta produce invece thin content su scala.
| Domanda | Segnale positivo | Segnale di rischio |
|---|---|---|
| Perché esiste la pagina? | Risolve un bisogno specifico | Copre una keyword aggiuntiva |
| Da dove arrivano i dati? | Fonte proprietaria o verificata | Scraping e combinazioni non controllate |
| Cosa cambia tra URL? | Offerta, fatti e decisioni | Solo nomi e frasi riscritte |
| Come viene pubblicata? | Regole e QA | Ogni combinazione diventa indicizzabile |
Casi d’uso adatti alla scala
Un progetto programmatico può essere sensato per:
- prodotti, modelli e compatibilità;
- categorie con attributi stabili e domanda distinta;
- directory con record verificati;
- integrazioni tra software;
- confronti basati su dati;
- sedi o aree realmente servite;
- statistiche aggiornate per mercato o periodo;
- template di documentazione tecnica.
Le pagine locali SEO, per esempio, possono usare componenti condivisi, ma ogni località deve avere servizio reale e valore unico. La generazione non può inventare presenza geografica.
Partire dal modello dei dati
Prima del layout, definisci entità, attributi, relazioni e fonte primaria. Ogni campo dovrebbe avere:
- proprietario;
- tipo e formato;
- regola di validazione;
- frequenza di aggiornamento;
- comportamento quando manca;
- tracciabilità della provenienza.
Se il dato è facoltativo, il template deve adattarsi senza lasciare blocchi vuoti o frasi spezzate. Se è essenziale, l’assenza deve impedire la pubblicazione.
Quali record devono essere esclusi dalla generazione
Per una pagina di compatibilità, un record minimo può contenere modello, componente, esito verificato, fonte e data di controllo. Se manca la fonte della compatibilità, il template non deve completare la frase per deduzione. Segnala il record al responsabile e tienilo fuori dal lotto finché la relazione non è verificata.
Aggiungi una chiave stabile per evitare URL duplicate quando cambia il nome commerciale. Il processo deve distinguere record nuovo, aggiornato, ritirato e incompleto e registrare quali pagine dipendono da ciascun dato. Quando una fonte cambia, questa relazione permette di trovare le pagine da ricontrollare. I sinonimi servono a rendere il testo naturale; non sostituiscono fatti specifici né giustificano una pagina per ogni combinazione di parole.
La regola di eleggibilità della pagina
Non ogni record del database merita un URL indicizzabile. Definisci una funzione di eleggibilità basata su domanda, completezza, unicità, disponibilità e stabilità.
Un esempio concettuale:
pubblica = domanda valida + dati minimi + offerta attiva + contenuto distinto + link interno
La soglia deve essere comprensibile e revisionabile. Evita punteggi opachi che nascondono pagine prive di informazioni essenziali.
Template: struttura condivisa, risposta distinta
Un buon template rende confrontabili le informazioni ma lascia emergere ciò che cambia. Può includere risposta breve, dati principali, criteri di scelta, limiti, alternative, fonte, data di aggiornamento e azione successiva.
Non usare sinonimi casuali per simulare unicità. L’unicità utile deriva da fatti, relazioni e conseguenze diverse. Un testo perfettamente originale può essere comunque vuoto.
Keyword mapping e cannibalizzazione
Costruisci una keyword map per template e intenti. Due pagine non devono esistere soltanto perché l’ordine delle variabili cambia.
Normalizza combinazioni equivalenti, definisci URL canonici e controlla sovrapposizioni. Se più URL ricevono impression per lo stesso bisogno, applica la diagnosi di cannibalizzazione SEO prima di unire o rimuovere.
Architettura e link interni
Le pagine programmatiche non devono vivere soltanto nella sitemap. Collegale da hub, categorie, breadcrumb e pagine correlate tramite normali elementi <a href>.
Limita spazi di URL infiniti e percorsi circolari. La guida all’internal linking aiuta a distribuire priorità senza creare migliaia di link in ogni pagina.
Canonical, parametri e varianti
Stabilisci un contratto URL: ordine delle variabili, caratteri, casing, slash, parametri e comportamento per combinazioni invalide. Le versioni equivalenti devono consolidarsi verso un solo URL.
Il canonical è un segnale di preferenza, non una soluzione a un generatore incontrollato. Riduci alla fonte gli URL inutili e usa redirect o status code coerenti quando il record cambia.
Sitemap e pubblicazione progressiva
Inserisci in sitemap soltanto pagine canoniche, attive e indicizzabili. Segmenta per template o mercato per leggere meglio copertura e problemi in Search Console.
Non lanciare subito l’intero inventario. Pubblica un campione rappresentativo, verifica rendering, qualità, crawling, indicizzazione e comportamento degli utenti. Estendi la scala dopo aver corretto il sistema.
QA automatico e revisione umana
I controlli automatici devono bloccare:
- record senza campi essenziali;
- title e H1 duplicati;
- canonical non coerenti;
- pagine con zero risultati;
- link interni rotti;
- markup non allineato ai dati visibili;
- URL fuori dal contratto;
- contenuti troppo simili oltre la soglia concordata.
La revisione umana valuta utilità, tono, eccezioni e possibili danni. Automatizzare il controllo non significa automatizzare la decisione editoriale.
Aggiornamenti, scadenza e rimozione
Ogni pagina deve avere un ciclo di vita. Quando un dato cambia, il sistema deve aggiornare pagina, feed e markup. Quando un’entità non esiste più, scegli tra sostituzione, archivio, redirect o 404/410 in base all’intento.
Il content pruning su un progetto programmatico deve partire da regole e segmenti, non da cancellazioni isolate.
Come misurare
- URL eleggibili, pubblicati e indicizzati;
- tempo tra pubblicazione e primo crawl;
- impression e clic per template;
- percentuale di pagine senza domanda;
- conversioni e valore per segmento;
- errori dati e tempo di correzione;
- costo di generazione e manutenzione;
- URL esclusi, duplicati o soft 404.
Una crescita del numero di pagine non è un risultato. La guida ai KPI SEO aiuta a collegare output e valore.
Checklist prima del lancio
- Intento e audience definiti.
- Fonti dati verificate e con owner.
- Regola di eleggibilità documentata.
- Template testato con dati completi e incompleti.
- URL, canonical e status code coerenti.
- Link interni e sitemap segmentati.
- QA automatico con blocchi di rilascio.
- Campione revisionato manualmente.
- Dashboard e rollback pronti.
- Processo di aggiornamento e rimozione attivo.
La scala deve moltiplicare valore
La programmatic SEO è sostenibile quando il sistema impedisce di pubblicare pagine deboli. Se il processo misura soltanto quante URL produce, l’automazione sta amplificando un problema editoriale.
Un esempio operativo: pagine di compatibilità
Immaginiamo un catalogo di ricambi che voglia creare pagine per la relazione tra componente e modello di macchina. La query non chiede un testo generico: chiede se un componente è compatibile, con quale versione, entro quali anni di produzione e con quali eventuali limitazioni. La pagina ha quindi diritto di esistere soltanto quando il database può rispondere a queste domande con dati verificati.
In questo contesto le entità vicine alla query — componente, marca, modello, versione, anno, codice prodotto, disponibilità e istruzioni di montaggio — non sono sinonimi inseriti per aumentare la densità. Sono gli elementi che definiscono la risposta. Tenerli nello stesso blocco informativo aiuta sia il lettore sia i sistemi che devono interpretare la relazione.
| Controllo | Pagina pubblicabile | Pagina da trattenere |
|---|---|---|
| Domanda | Esiste un bisogno distinto di compatibilità | La combinazione non ha un’utilità osservabile |
| Dati | Modello, versione e compatibilità sono confermati | Il template deduce informazioni mancanti |
| Offerta | Esiste un prodotto disponibile o un’alternativa utile | La pagina conduce a zero risultati |
| Differenza | Cambiano fatti e conseguenze per l’utente | Cambia soltanto il nome nel titolo |
| Scoperta | La pagina riceve link da un hub coerente | L’URL compare soltanto nella sitemap |
Il contratto di qualità prima della generazione
Prima di scrivere codice conviene trasformare la strategia in un contratto verificabile. Il contratto definisce quali campi sono obbligatori, quali combinazioni sono valide, chi possiede ogni dato, quando una pagina scade e quali errori bloccano la pubblicazione. In questo modo SEO, prodotto e sviluppo discutono di condizioni osservabili invece che di una generica “qualità del contenuto”.
Un controllo robusto distingue inoltre quattro stati: URL non generato, URL generato ma non indicizzabile, URL indicizzabile e URL ritirato. Questa separazione evita che un record incompleto venga pubblicato e poi affidato a canonical o noindex come correzione tardiva. La gestione dell’indice comincia nel modello dei dati, non nel tag robots.
Come valutare valore e rischio dopo il lancio
Il campione iniziale dovrebbe includere record completi, incompleti, molto simili, senza offerta e con domanda differente. Dopo il rilascio confronta copertura in Search Console, richieste di Googlebot, query effettive, engagement e azioni commerciali per template. Una pagina con poche impression può essere utile se risolve un bisogno raro e converte; migliaia di URL senza impression, link o offerta indicano invece che la regola di eleggibilità è troppo permissiva.
Documenta anche la provenienza delle affermazioni e la data di aggiornamento dei dati. È un segnale operativo di affidabilità: permette di correggere rapidamente un’informazione e impedisce che un template continui a diffondere un errore. La policy di Google sullo scaled content abuse chiarisce perché la generazione su larga scala deve aggiungere valore indipendentemente dallo strumento usato.
Valuta architettura, dati e QA di un progetto programmatic SEO