Lo schema markup SEO aiuta i motori di ricerca a interpretare entità, attributi e relazioni presenti in una pagina. Non sostituisce il contenuto, non garantisce un rich result e non migliora una pagina povera. Il suo valore nasce quando traduce in dati strutturati informazioni reali, visibili e coerenti con ciò che l’utente può verificare.
Il problema, nei siti complessi, raramente è “aggiungere Schema.org”. È decidere quale entità descrivere, da quale fonte ricavare i dati, come evitare markup duplicato e chi controlla che prezzo, autore, disponibilità o recensioni restino corretti dopo ogni aggiornamento.
Che cos’è lo schema markup e cosa può fare
Schema.org fornisce un vocabolario condiviso. Google supporta alcuni tipi e proprietà per specifiche funzioni nella Ricerca, ma non tutto il vocabolario genera trattamenti visivi. Una pagina può quindi avere markup semanticamente valido senza essere idonea a un risultato avanzato.
Il formato generalmente più gestibile è JSON-LD: separa la rappresentazione strutturata dal markup visivo e può essere generato da template o componenti. Questa comodità non elimina il requisito principale: i dati devono descrivere il contenuto effettivo della pagina.
Partire dall’entità principale, non dal plugin
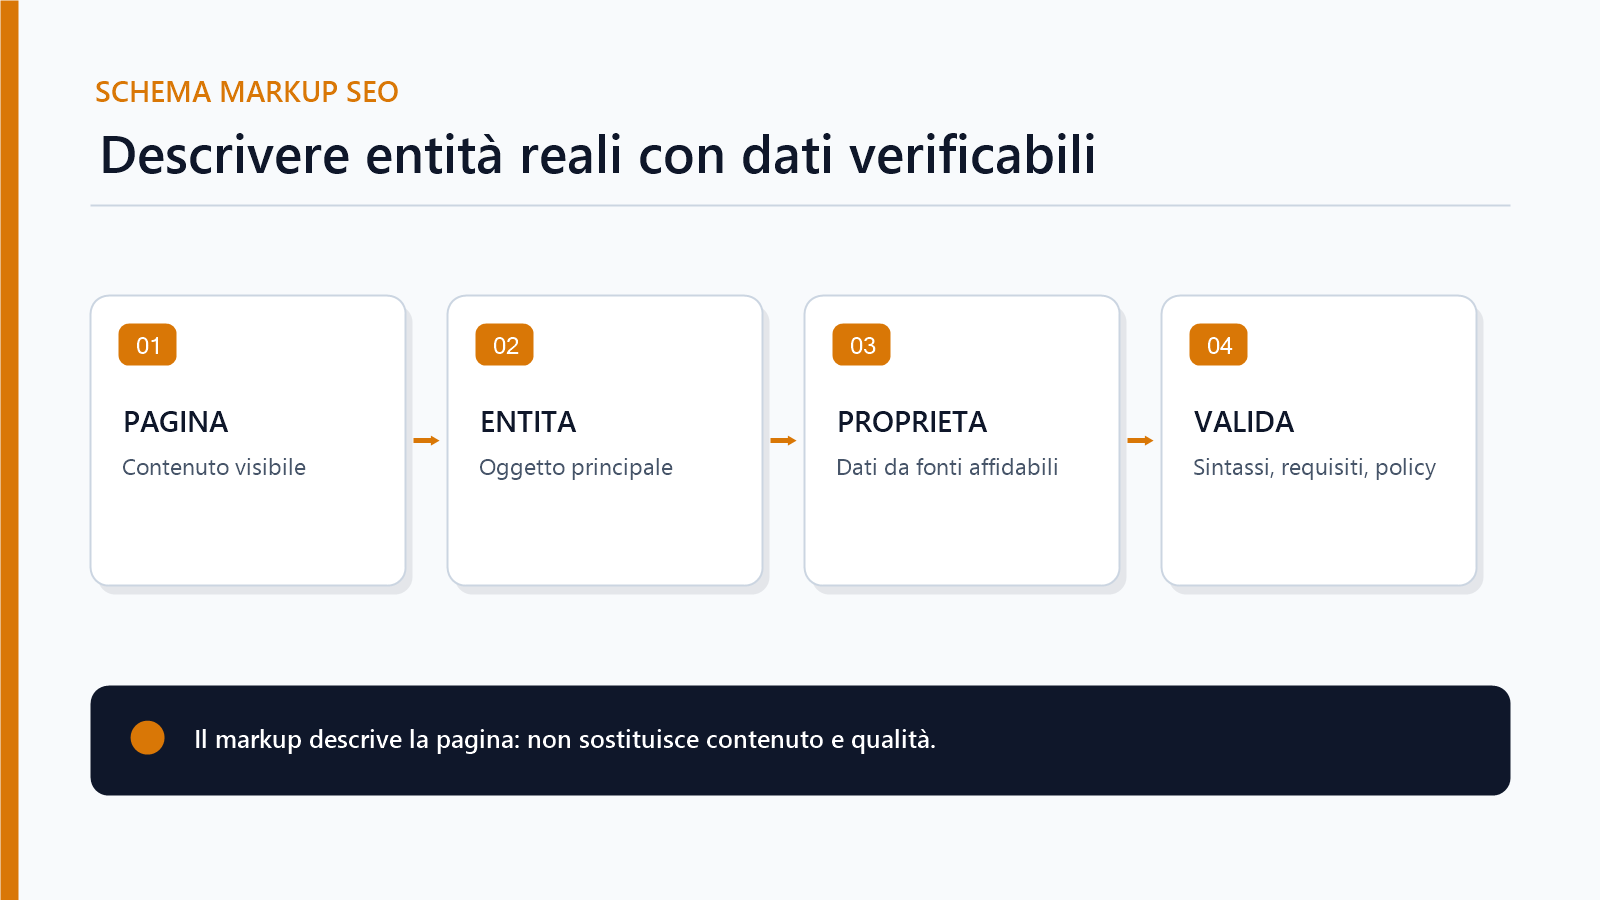
Prima di scegliere un tipo, chiarisci che cosa rappresenta la pagina. Un articolo ha un soggetto editoriale e un autore; una scheda prodotto presenta un prodotto o un’offerta; una pagina aziendale descrive un’organizzazione; una breadcrumb espone la posizione nell’architettura. Inserire più tipi senza una gerarchia chiara crea rumore, soprattutto quando tema, plugin SEO, app e codice custom generano blocchi separati.
Un modello utile distingue:
- entità principale: ciò di cui tratta prevalentemente la pagina;
- entità collegate: autore, organizzazione, brand, offerta o luogo;
- proprietà: dati verificabili come nome, URL, immagine, data o prezzo;
- identificatori: URL o
@idstabili, utili a collegare nodi dello stesso grafo.
Tipi supportati e idoneità reale
La scelta non dovrebbe partire dalla SERP desiderata, ma dai requisiti documentati e dal contenuto disponibile. Se una proprietà obbligatoria manca, non inventarla. Se un’informazione non è visibile all’utente, non nasconderla soltanto nel JSON-LD. Se il tipo non corrisponde alla pagina, un test “valido” non rende la strategia corretta.
Per un sito editoriale possono essere pertinenti Article, BlogPosting e BreadcrumbList. Per un e-commerce, Product e le proprietà dell’offerta richiedono una governance molto più stretta. I dettagli cambiano nel tempo: la documentazione ufficiale di Google deve essere la fonte operativa, non uno snippet copiato anni prima.
JSON-LD generato da una sola fonte affidabile
Il markup dovrebbe derivare dagli stessi dati che alimentano il contenuto visibile. Prezzo e stock possono arrivare dal catalogo; autore e data dal CMS; breadcrumb dalla gerarchia; logo e profilo aziendale da una configurazione centrale. Se ogni proprietà viene compilata manualmente, la divergenza è quasi inevitabile.
Definisci inoltre chi possiede ciascun dato. Il team SEO può stabilire requisiti e controlli, ma non dovrebbe diventare il proprietario del prezzo o della disponibilità. La struttura dei collegamenti interni, i template e i dati strutturati devono raccontare la stessa architettura.
Un identificatore stabile collega le entità
Esempio didattico, da adattare a dati reali: una pagina può identificare l’organizzazione con https://example.com/#organization e riferirsi allo stesso identificatore nella proprietà publisher dell’articolo. L’identificatore collega le descrizioni della medesima entità; non deve cambiare a ogni aggiornamento del template.
La stringa di esempio non è markup da pubblicare sul tuo sito. In produzione usa la tua URL, proprietà pertinenti e dati coerenti con la pagina. Controlla il grafo completo per evitare che due plugin descrivano la stessa organizzazione con nomi o loghi diversi. Più blocchi JSON-LD possono coesistere se coerenti; un errore di sintassi, un’identità contraddittoria e una mancata idoneità ai rich result sono problemi distinti da diagnosticare separatamente.
Errori frequenti nello schema markup SEO
- due plugin generano due entità principali incompatibili;
- il markup contiene recensioni aggregate non presenti o non riferite all’elemento corretto;
- prezzo, valuta o disponibilità non coincidono con la pagina;
- URL e
@idcambiano tra varianti, ambienti o richieste; - le date vengono aggiornate senza una modifica editoriale reale;
- il markup è valido sintatticamente, ma non rispetta le policy del tipo supportato;
- staging, anteprime o dati di esempio finiscono in produzione.
Questi problemi non vanno trattati come semplici warning. Possono segnalare una pipeline dati fragile o un template non governato.
Validazione: tre livelli diversi
Un controllo serio separa almeno tre domande. Primo: il JSON è parsabile? Secondo: il grafo usa correttamente il vocabolario e contiene i campi previsti? Terzo: Google considera la pagina idonea e il contenuto conforme alle proprie linee guida? Il Rich Results Test aiuta sul terzo livello per i tipi supportati; Schema Markup Validator è utile per la struttura generale; l’ispezione URL e i report di Search Console mostrano ciò che Google ha elaborato.
La presenza di zero errori non implica che il risultato avanzato verrà mostrato. Google valuta anche qualità, pertinenza, policy e contesto della query. Evita quindi KPI come “numero di pagine con schema” senza una misura di correttezza e copertura utile.
Implementazione e QA nei rilasci
Per ogni template crea esempi di riferimento e casi limite: proprietà mancanti, prodotti esauriti, immagini assenti, autori rimossi, categorie profonde e pagine paginate. Automatizza la validazione del JSON e dei campi essenziali, poi aggiungi un controllo umano sui casi ad alto impatto.
Una checklist di rilascio dovrebbe verificare:
- una sola entità principale coerente con la pagina;
- dati visibili e strutturati allineati;
- URL canonico e identificatori corretti;
- assenza di dati di staging o placeholder;
- test su una selezione di URL reali, non solo sul template ideale;
- monitoraggio degli errori dopo il deploy.
Integra questi controlli nella checklist SEO tecnica e nell’audit dei template, invece di eseguirli solo quando un report registra un calo.
Come monitorare i dati strutturati
Segmenta per tipo di pagina e release. Se gli errori aumentano soltanto sulle schede prodotto di un mercato, la causa può essere un feed locale; se scompaiono contemporaneamente più tipi, controlla il layout o il plugin comune. Confronta copertura valida, errori, warning utili e impression dei relativi risultati, senza attribuire automaticamente ogni variazione al markup.
Conserva una cronologia delle modifiche. Sapere quando è cambiato un template, un plugin o un modello dati accelera molto la diagnosi. Nei siti grandi, una verifica SEO strutturata dovrebbe includere sia il codice renderizzato sia la fonte che alimenta le proprietà.
Quando intervenire
Serve priorità quando il markup descrive informazioni errate, viola le linee guida, sparisce da template strategici o diverge dal contenuto. Un warning su una proprietà raccomandata può invece essere valutato rispetto a disponibilità del dato e beneficio reale. Non tutti i messaggi meritano la stessa urgenza.
Quattro livelli di qualità del markup
Un test superato non dimostra che i dati strutturati siano corretti. La qualità va verificata su quattro livelli: sintassi valida, proprietà ammesse per la feature, corrispondenza con il contenuto visibile e aggiornamento rispetto alla fonte operativa. Un JSON-LD può essere perfettamente leggibile ma descrivere un prezzo scaduto, una recensione inesistente o un’entità diversa dalla pagina.
| Livello | Domanda di controllo | Prova |
|---|---|---|
| Sintassi | Il codice può essere interpretato? | Validator e test automatico |
| Idoneità | Il tipo segue i requisiti della feature? | Documentazione Google aggiornata |
| Veridicità | Le proprietà descrivono ciò che l’utente vede? | Confronto DOM–JSON-LD |
| Freschezza | I valori seguono la fonte primaria? | Timestamp, feed e monitoraggio |
Esempio: collegare le entità senza inventarle
In una scheda prodotto, Product identifica l’articolo, Offer descrive l’offerta del merchant e Organization rappresenta l’azienda. SKU, GTIN, brand, prezzo, valuta e disponibilità devono provenire dagli stessi sistemi che alimentano pagina e checkout. Un identificatore stabile può collegare i nodi; una proprietà promozionale inserita soltanto nel markup crea invece una contraddizione.
Il contesto vicino conta anche per chi implementa: spiegare nello stesso blocco quale entità viene descritta, da quale fonte arriva e dove è visibile riduce ambiguità. Lo schema non serve a elencare keyword correlate. Serve a rendere esplicite relazioni reali tra pagina, oggetto, autore, organizzazione o offerta.
Deployment e rollback del JSON-LD
Tratta il markup come codice di produzione. Versiona i template, crea fixture con dati completi e mancanti, controlla duplicati tra plugin e tema e testa un campione per tipologia. Un rilascio deve poter essere annullato senza rimuovere il contenuto visibile o rompere il checkout.
- Blocca valori vuoti o placeholder prima del rendering.
- Confronta proprietà critiche con DOM, API e feed.
- Monitora errori e miglioramenti per template, non solo per singolo URL.
- Registra chi ha approvato il cambiamento e quale requisito soddisfa.
L’introduzione ufficiale ai dati strutturati ricorda che il markup aiuta Google a comprendere il contenuto e può rendere la pagina idonea a determinate esperienze, ma non garantisce che una funzionalità venga mostrata. Questa distinzione deve restare vicina alla decisione: implementare markup corretto aumenta chiarezza e idoneità, non crea un risultato garantito.
Se il sito produce markup diverso tra CMS, plugin e applicazioni, il lavoro non è aggiungere un altro blocco JSON-LD: è definire un modello delle entità, una fonte autorevole e un processo di QA. Contattami per un audit dei dati strutturati e dei template prima di estendere l’implementazione su migliaia di URL.